Kubernetes для самых маленьких. Часть 39: Запускаем рабочие нагрузки, хранилище и наблюдаемость на Windows
Все части серии «Kubernetes для самых маленьких»В прошлой части мы собрали тестовый гибридный кластер: control plane k8s-lab-master-1, Linux-воркеры k8s-lab-node-1 и k8s-lab-node-2 и Windows-воркер k8s-lab-win-1. На Windows-узле kubelet и containerd работают службами Windows, Calico в режиме VXLAN и kube-proxy в режиме winkernel — в HostProcess-подах, узел закрыт taint os=windows:NoSchedule, а Windows-поды попадают на него через RuntimeClass windows-2025. Проверяли мы его на готовом примере Microsoft — веб-приложении aspnetapp на Nano Server, и два его пода работают до сих пор. Сегодня на узел приходят собственные рабочие нагрузки и всё, без чего их нельзя эксплуатировать: соберём hello под Windows и выпустим один мультиплатформенный тег для обеих ОС, разберём, что на Windows значат requests и limits, пробы и остановка пода, поставим в тестовый кластер csi-driver-smb и подключим SMB-тома, поднимем в нём Loki и kube-prometheus-stack, соберём логи и метрики Windows-узла и опишем, как обновлять Windows-узел каждый месяц и при переходе на новую версию Windows Server.
Команды kubectl и helm в этой части идут в тестовый кластер: в kubeconfig он выбран контекстом lab из части 38, а в командах установки контекст указан явно. Основной кластер эта часть не трогает: всё, что нужно для наблюдаемости, ставится в тестовый.
Windows-образы: nanoserver, servercore, server
У Linux-образа база может быть почти пустой: distroless/static из части 5 весит пару мегабайт, статическому бинарю нужно только ядро. Программы для Windows обращаются к системе через пользовательские библиотеки (kernel32.dll, ntdll.dll), а часть нужных им служб тоже работает в пользовательском режиме, поэтому базовый образ содержит пользовательскую часть Windows, а в контейнере рядом с приложением работают системные процессы. Microsoft публикует три базовых образа в реестре mcr.microsoft.com:
| Образ | Что внутри | Размер в сжатом виде |
|---|---|---|
windows/nanoserver |
минимальная Windows: cmd.exe, curl.exe, tar.exe, без PowerShell, без .NET Framework, без установщика MSI |
около 200 МБ |
windows/servercore |
Windows Server без графической оболочки: PowerShell, .NET Framework, WMI, роли вроде IIS | порядка гигабайта и больше |
windows/server |
полный набор API Windows Server, включая графические библиотеки, — для программ, которым не хватает servercore | несколько гигабайт |
Выбор простой: приложение, собранное в один исполняемый файл без зависимостей от .NET Framework, — Go, Rust, современный .NET в самодостаточной публикации — кладут на nanoserver. Всё, что требует PowerShell при запуске, .NET Framework 4.x, IIS или установки через MSI, — на servercore. server нужен редко.
Ещё два отличия от Linux. Пользователь по умолчанию: в nanoserver — ContainerUser без прав администратора, в servercore — ContainerAdministrator. Оба существуют только внутри контейнера, на узле таких учётных записей нет. Теги привязаны к версии Windows: ltsc2022 — сборка 20348, ltsc2025 — сборка 26100; тега latest у базовых образов нет. Почему версия образа важна, разобрано в части 36: при process isolation контейнер работает на ядре узла, и пользовательская часть Windows в образе должна быть с ним совместима.
С 2023 года базовые слои Windows-образов — обычные слои OCI. Раньше они были «внешними» (foreign layers): в манифесте лежала только ссылка на MCR, реестр их не хранил, и узлы при каждом скачивании ходили за базой в интернет. Теперь docker push в ghcr.io отправляет все слои, и Windows-узлу достаточно того реестра, где лежит образ.
Мультиплатформенный образ и os.version
В части 5 мы разбирали index — оглавление образа со списком манифестов под разные платформы. Платформа в дескрипторе манифеста — это не только os и architecture: у неё есть поле os.version, и для Windows оно главное.
 тег ghcr.io/example/hello:1.3
   │
   ▼
 Index (application/vnd.oci.image.index.v1+json)
   ├─ manifest   linux/amd64
   ├─ manifest   linux/arm64
   ├─ manifest   windows/amd64   os.version 10.0.26100.33674
   │               ├─ слой: nanoserver ltsc2025 (базовый)
   │               └─ слой: C:\app\hello.exe
   └─ attestation × 3   (platform unknown/unknown)

 k8s-lab-node-1, linux/amd64              → manifest linux/amd64
 k8s-lab-win-1,  windows/amd64, 10.0.26100 → manifest windows/amd64
Версия Windows состоит из четырёх чисел: 10.0.26100.33674 — major, minor, build и revision (UBR, update build revision). Build меняется только с выходом новой версии ОС: 20348 — Windows Server 2022, 26100 — Windows Server 2025. Revision растёт с каждым ежемесячным обновлением.
containerd на Windows-узле выбирает манифест так (код сопоставления платформ): ОС и архитектура должны совпасть, затем сравниваются major, minor и build из os.version, а revision не учитывается вовсе. На узле с Windows Server 2025 подходящим считается образ со сборкой от 20348 до 26100 включительно — это повторяет таблицу совместимости Microsoft, где Windows Server 2025 запускает в process isolation и образы Windows Server 2022. Если подходящих вариантов несколько, берётся вариант с большей версией. Если поля os.version в индексе нет, подходит любой Windows-вариант — и при несовместимой сборке контейнер упадёт уже при запуске с ошибкой The operating system of the container does not match the operating system of the host. Поэтому для Windows поле os.version в индексе обязательно на практике, а не по спецификации.
Узлу с Windows Server 2022 вариант 26100 не подойдёт: более новый образ на старом ядре не запускается никогда. Это ограничение пригодится в разделе об обновлениях.
Сборка hello под windows/amd64
Код hello не меняется: это та же версия, что после части 33, с log/slog, метриками и трассировкой. Go компилирует её под Windows без единой правки, включая обработку SIGTERM — почему это работает, разберём в разделе о завершении. Новый только Dockerfile:
# syntax=docker/dockerfile:1

# --- сборка: всегда на платформе машины сборки ---
FROM --platform=$BUILDPLATFORM golang:1.27 AS build
ARG TARGETOS TARGETARCH
ARG VERSION=dev
WORKDIR /src
COPY go.mod go.sum ./
RUN --mount=type=cache,target=/go/pkg/mod go mod download
COPY *.go ./
RUN --mount=type=cache,target=/go/pkg/mod \
    --mount=type=cache,target=/root/.cache/go-build \
    CGO_ENABLED=0 GOOS=$TARGETOS GOARCH=$TARGETARCH \
    go build -trimpath -ldflags="-s -w -X main.version=${VERSION}" -o /out/hello .

# --- итоговый образ для Linux ---
FROM gcr.io/distroless/static-debian13:nonroot AS final-linux
COPY --from=build /out/hello /hello
USER 65532:65532
ENTRYPOINT ["/hello"]

# --- итоговый образ для Windows ---
FROM mcr.microsoft.com/windows/nanoserver:ltsc2025 AS final-windows
COPY --from=build /out/hello /app/hello.exe
USER ContainerUser
ENTRYPOINT ["C:\\app\\hello.exe"]

# --- выбор по целевой ОС ---
FROM final-${TARGETOS}
ARG VERSION=dev
LABEL org.opencontainers.image.title="hello" \
      org.opencontainers.image.version="${VERSION}" \
      org.opencontainers.image.source="https://git.example.com/demo/hello"
EXPOSE 8080
- Этап
buildпо-прежнему работает на платформе машины сборки, а Go кросс-компилирует бинарь подGOOS=windows; расширение.exeдобавляется при копировании. FROM final-${TARGETOS}выбирает итоговый этап: BuildKit подставляет встроенный аргументTARGETOSдля каждой платформы отдельно и строит только нужные этапы.- В Windows-этапе нет
RUN— главное условие сборки Windows-образа на Linux.COPY,LABEL,USER,ENTRYPOINTBuildKit выполняет сам: распаковывает базовые слои, пишет новый слой в формате Windows и правит config.RUNже — запуск процесса внутри образа, а запуститьcmd.exeна Linux-ядре невозможно, эмулятора вроде QEMU для Windows нет. ENTRYPOINTв exec-форме с полным путём: форма с командной строкой вызвала бы оболочку, а при сборке на Linux BuildKit записал бы в config/bin/sh -c. Exec-форма — это массив JSON, поэтому обратная косая черта в пути удваивается:"C:\app\hello.exe"— уже не JSON (\aв нём недопустимая escape-последовательность), и Docker молча прочитал бы строку как форму с командной строкой.
Сборка — той же командой, что в части 5, с третьей платформой. Ниже — главное из подробного вывода (--progress=plain):
$ docker buildx build --platform linux/amd64,linux/arm64,windows/amd64 \
    --build-arg VERSION=1.3 \
    -t ghcr.io/example/hello:1.3 --push .
#0 building with "multi" instance using docker-container driver
...
#10 [windows/amd64 final-windows 1/2] FROM mcr.microsoft.com/windows/nanoserver:ltsc2025@sha256:05d1a7fb562f998ed3bc23b21dbd95aa26b3dd10ae921e830449e2db657f6704
#25 [linux/amd64->windows/amd64 build 6/6] RUN --mount=type=cache,target=/go/pkg/mod     --mount=type=cache,target=/root/.cache/go-build     CGO_ENABLED=0 GOOS=windows GOARCH=amd64     go build -trimpath -ldflags="-s -w -X main.version=1.3" -o /out/hello .
#27 [windows/amd64 final-windows 2/2] COPY --from=build /out/hello /app/hello.exe
...
#28 pushing manifest for ghcr.io/example/hello:1.3@sha256:912dccf9f068f7210f3673cbf4e8f14dc66772a47ed59b3264746f46ffdd180c 3.4s done
Строка linux/amd64->windows/amd64 — кросс-компиляция Windows-бинаря на Linux. Сборка трёх платформ заняла полторы минуты, большую часть — скачивание базы nanoserver. Тег новый — 1.3, хотя код тот же, что в 1.2: теги неизменяемы (часть 5), а в теге появилась третья платформа.
Откуда в индексе os.version
Поле os.version BuildKit берёт из config базового образа: у nanoserver:ltsc2025 там записана его версия, и BuildKit переносит её в дескриптор Windows-манифеста в индексе. Так он делает с 2023 года (PR #3619), а в версии 0.20 исправлена регрессия, при которой версия терялась (PR #5714). Проверить результат — по сырому индексу:
$ docker buildx imagetools inspect ghcr.io/example/hello:1.3 --raw | \
    jq -c '.manifests[] | .platform' | grep -v unknown
{"architecture":"amd64","os":"linux"}
{"architecture":"arm64","os":"linux"}
{"architecture":"amd64","os":"windows","os.version":"10.0.26100.33674"}
Версия 10.0.26100.33674 — ревизия базового образа, и она новее, чем на нашем узле (26100.33438): совпадать должна только сборка. В старых инструкциях поле дописывают руками командой docker manifest annotate --os-version; с актуальным BuildKit это не нужно.
Размеры вариантов в одном теге отличаются в тридцать раз: у Linux-варианта приложение — слой около 6 МБ поверх пары крошечных слоёв distroless, у Windows-варианта — тот же 6-мегабайтный слой поверх 194 МБ базы nanoserver.
Когда без RUN не обойтись
Приложению на servercore часто нужен RUN: включить компонент Windows, выполнить установщик, настроить IIS через PowerShell. Такую сборку выполняют на Windows-машине: в BuildKit с версии 0.13 есть buildkitd.exe для Windows с воркером на containerd, к которому buildx подключается драйвером remote через именованный канал (named pipe — механизм межпроцессного обмена Windows, файлоподобный объект вида \\.\pipe\buildkitd), но документация BuildKit всё ещё называет эту поддержку экспериментальной. Проверенный годами путь — Docker Engine на Windows Server с классическим сборщиком. Затем Windows- и Linux-варианты объединяют в один тег без пересборки:
$ docker buildx imagetools create -t ghcr.io/example/app:2.0 \
    ghcr.io/example/app:2.0-linux \
    ghcr.io/example/app:2.0-windows-ltsc2025
imagetools create переносит платформу каждого варианта, включая os.version из его config, в новый индекс. Так же собирается индекс с двумя Windows-вариантами, когда в кластере узлы двух версий Windows Server.
Сертификат у ghcr.io публичный, и Windows-узлу, как и Linux-узлам, настраивать доверие не нужно. Своему реестру с внутренним CA, как в разделе «Свой реестр» части 5, Windows-узел доверял бы через тот же hosts.toml в каталоге config_path из C:\Program Files\containerd\config.toml. Secret ghcr-pull и его привязку к ServiceAccount default повторяем в неймспейсе win-demo — как в неймспейсе demo в части 38.
hello-win в кластере
Windows-вариант работает отдельным Deployment hello-win со своим Service в неймспейсе win-demo. Общий Deployment для двух ОС не получится: шаблон пода Linux-варианта содержит поля securityContext, которые на Windows запрещены (runAsUser, seccompProfile, capabilities), а под с .spec.os.name: windows и любым из них API-сервер не примет.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: hello-win
  namespace: win-demo
  labels:
    app.kubernetes.io/name: hello-win
spec:
  replicas: 2
  selector:
    matchLabels:
      app.kubernetes.io/name: hello-win
  template:
    metadata:
      labels:
        app.kubernetes.io/name: hello-win
    spec:
      os:
        name: windows
      runtimeClassName: windows-2025
      terminationGracePeriodSeconds: 30
      securityContext:
        runAsNonRoot: true
        windowsOptions:
          runAsUserName: ContainerUser
      containers:
      - name: hello
        image: ghcr.io/example/hello:1.3
        ports:
        - name: http
          containerPort: 8080
        env:
        - name: OTEL_TRACES_SAMPLER   # коллектора трасс в тестовом кластере нет
          value: always_off
        resources:
          requests:
            cpu: 250m
            memory: 256Mi
          limits:
            cpu: 500m
            memory: 256Mi
        startupProbe:
          httpGet: { path: /healthz, port: http }
          periodSeconds: 2
          failureThreshold: 30
        readinessProbe:
          httpGet: { path: /readyz, port: http }
          periodSeconds: 5
        livenessProbe:
          httpGet: { path: /healthz, port: http }
          periodSeconds: 10
          timeoutSeconds: 3
        lifecycle:
          preStop:
            sleep:
              seconds: 5
---
apiVersion: v1
kind: Service
metadata:
  name: hello-win
  namespace: win-demo
spec:
  selector:
    app.kubernetes.io/name: hello-win
  ports:
  - name: http
    port: 80
    targetPort: http
- Неймспейс
win-demo— тот же, что дляaspnetappв части 38, с уровнемrestrictedPod Security Admission (часть 30).hello-winнаnanoserverсContainerUserпроходит его без предупреждений. os.name: windowsсообщает API-серверу и PSA, что это Windows-под. Для таких подов PSA не требует Linux-полей — профиля seccomp, сброса capabilities, запрета повышения привилегий, — которые на Windows не существуют. АrunAsNonRoot: trueпроверяется и здесь: kubelet на Windows отказывается запускать контейнер, если его пользователь —ContainerAdministrator.runtimeClassName: windows-2025приноситnodeSelectorс меткой сборки и toleration к taint узла — без них под остался быPending.startupProbe— на Windows запуск контейнера заметно дольше, чем на Linux: HCS создаёт для него изолированное окружение и запускает системные процессы. Проба запуска даёт до минуты, не растягивая интервалыlivenessProbe.OTEL_TRACES_SAMPLER: always_off—helloиз части 33 отправляет трассы в OpenTelemetry Collector, которого в тестовом кластере нет; без этой переменной в логе каждые несколько секунд появлялась бы ошибка экспорта на127.0.0.1:4317.
Поды Linux и Windows видят друг друга по именам сервисов, как в части 38, — по полным именам: короткие вида hello.demo из Windows-подов не разрешаются (почему — в части 37). Linux-вариант hello работает в неймспейсе demo тестового кластера — те же поды на Linux-воркерах и Service hello, что в части 38. Проверочный под probe, как check в части 38, запускаем в default, где нет ограничений Pod Security:
$ kubectl run probe --rm -i --restart=Never --image=busybox:1.37 -- wget -qO- http://hello-win.win-demo.svc.cluster.local
hello from hello-win-759c899954-tq5nc
pod "probe" deleted from default namespace
$ kubectl -n win-demo exec deploy/hello-win -- curl.exe -s http://hello.demo.svc.cluster.local
hello from hello-55fb8f8684-69mvv
$ kubectl -n win-demo exec deploy/hello-win -- curl.exe -s -m 5 http://hello.demo
command terminated with exit code 6
Ресурсы на Windows
В части 10 requests и limits превращались в файлы cgroup v2. В части 36 мы коротко видели, что на Windows всё иначе; теперь подробно. Cgroups на Windows нет, и границу контейнера задаёт job object — объект ядра Windows, который объединяет группу процессов и накладывает на неё общие правила: лимит памяти, лимит процессорного времени, число процессов. Процесс внутри job object и все его потомки остаются в нём навсегда, а при закрытии job object завершаются разом. Для каждого контейнера HCS создаёт свой job object и запускает в нём системные процессы контейнера и приложение (документация Kubernetes).
kubelet передаёт containerd через CRI параметры для Windows, и вот как они вычисляются (код kubelet):
| Поле манифеста | Что получает job object | Для 250m/500m/256Mi на узле с 4 CPU |
|---|---|---|
limits.cpu |
CpuMaximum — доля процессорного времени всего узла в десятитысячных: 10 × миллиядра / число CPU |
10 × 500 / 4 = 1250, то есть 12,5 % узла |
нет limits.cpu |
ничего — без ограничения | — |
requests.cpu |
ничего | — |
limits.memory |
MemoryLimitInBytes — лимит выделенной памяти job object |
268435456 |
requests.memory |
ничего | — |
Главное отличие от Linux — requests в ядро не попадают совсем. На Linux request процессора становится весом cpu.weight; на Windows kubelet вес не задаёт намеренно — в коде сказано, что раньше вес выставлялся и мешал лимитам действовать. Windows ограничивает процессорное время сверху, но не гарантирует минимум. Requests остаются суммой для планировщика (часть 13), а защиту от «шумного соседа» дают только limits. Лимит процессора — жёсткий потолок job object, и эффект тот же, что у throttling CFS в части 10: средняя загрузка низкая, а отдельные запросы ждут.
Память без OOM killer
Здесь разница принципиальная. В Windows нет OOM killer — компонента ядра, который при нехватке памяти выбирает и убивает процесс. Память в Windows сначала выделяется (commit): система обещает процессу, что страницы будут, и учитывает обещанное в счёт предела выделения (commit limit) — суммы физической памяти и файла подкачки. Файл подкачки (pagefile.sys) на Windows обязателен, и при нехватке физической памяти страницы уходят туда: узел замедляется, но процессы не убиваются (документация Kubernetes).
Лимит памяти job object ограничивает именно выделенную память всех процессов контейнера вместе. Когда процесс просит больше, функция выделения памяти (VirtualAlloc) просто возвращает ошибку, а что будет дальше, решает программа. Проверим на hello-win с лимитом 256 МиБ. Возьмём маленькую программу на Go memhog.exe, которая выделяет память кусками по 16 МиБ и трогает каждую страницу, скопируем её в работающий под — kubectl cp работает и с Windows-контейнером, в nanoserver есть tar.exe — и запустим рядом с hello.exe, в том же job object:
$ kubectl cp memhog.exe win-demo/hello-win-8658cc7d9-gghk2:/Users/ContainerUser/memhog.exe
$ kubectl -n win-demo exec hello-win-8658cc7d9-gghk2 -- cmd /c "C:\Users\ContainerUser\memhog.exe"
allocated 16 MiB
allocated 32 MiB
...
allocated 128 MiB
runtime: VirtualAlloc of 16777216 bytes failed with errno=1455
fatal error: out of memory

runtime stack:
runtime.throw({0x7ff7bdeb8637?, 0xd8099ff800?})
...
^C
$ kubectl -n win-demo get pod hello-win-8658cc7d9-gghk2
NAME                        READY   STATUS    RESTARTS   AGE
hello-win-8658cc7d9-gghk2   1/1     Running   0          5m52s
Ошибка 1455 — ERROR_COMMITMENT_LIMIT: предел выделения job object исчерпан. memhog получил всего 128 МиБ из 256: остальное уже выделено hello.exe (около 95 МиБ — Go резервирует память с запасом) и системным процессам контейнера. Go-рантайм на такой отказ завершает процесс с fatal error: out of memory и кодом выхода 2; .NET бросает OutOfMemoryException, программа на C может проверить результат и выжить. Упавший memhog после трассы стека завис, и exec пришлось прервать, а под продолжил работать как ни в чём не бывало: ни перезапуска, ни OOMKilled. Если бы памяти не хватило главному процессу, Kubernetes увидел бы обычное падение контейнера с кодом выхода и reason: Error — не OOMKilled. Причину тогда ищут в логе предыдущего запуска (kubectl logs --previous) и в метрике выделенной памяти контейнера, о которой ниже. Отсюда следствия:
- Лимит памяти — с запасом на систему контейнера: в job object живут и системные процессы, у
nanoserverэто несколько десятков мегабайт, и считается выделенная память, а не рабочий набор, который показываетkubectl top. - requests = limits по памяти: без лимитов поды могут выделить больше физической памяти узла, и весь узел уйдёт в подкачку; документация прямо рекомендует задавать limits всем Windows-подам.
- Выселения по памяти нет: kubelet на Windows не выселяет поды при нехватке памяти и не реализует
--enforce-node-allocatable, а класс QoS показывается в статусе, но ни на что, кроме порядка планирования, не влияет. ПорогevictionHardпри этом всё равно вычитается изallocatable: уk8s-lab-win-1памяти для подов на 500 МиБ меньше, чем у узла.
Резерв и приоритет kubelet. systemReserved и kubeReserved на Windows только уменьшают allocatable; документация советует резервировать не меньше 2 ГиБ памяти и запускать kubelet с --windows-priorityclass=ABOVE_NORMAL_PRIORITY_CLASS, чтобы поды не оставили его без процессорного времени. ConfigMap kubelet-config у kubeadm общий для всех узлов, поэтому такие настройки кладут на сам Windows-узел — во флаги службы в C:\var\lib\kubelet\kubeadm-flags.env или в патч C:\k\patches, как maxPods в части 38. И последнее: изменение ресурсов пода на месте (in-place resize из части 10) Windows-поды не поддерживают, хотя функция на Windows-узле включена.
Пробы и корректное завершение
Пробы HTTP и TCP kubelet выполняет со стороны узла, как на Linux. Exec-пробы тоже работают, но каждая запускает новый процесс в контейнере через HCS, а это на Windows заметно дольше, — такой пробе дают timeoutSeconds побольше и помнят, что в nanoserver нет PowerShell, только cmd.exe.
Остановка контейнера. Сигналов POSIX в Windows нет. Вместо них есть управляющие события консоли: система вызывает в процессе зарегистрированный обработчик с кодом события — CTRL_C_EVENT, CTRL_CLOSE_EVENT, CTRL_SHUTDOWN_EVENT и другими. При остановке контейнера runhcs — прослойка containerd для Windows (shim) — просит HCS корректно завершить контейнер, процессы внутри получают CTRL_SHUTDOWN_EVENT, как при выключении компьютера, а по истечении terminationGracePeriodSeconds контейнер завершается принудительно вместе со своим job object. Раньше в контейнерах на servercore срок ожидания определяла сама Windows — 5 секунд параметра реестра WaitToKillServiceTimeout, — но это исправлено в hcsshim в 2023 году (PR #1416), и containerd 2.2.2 на k8s-lab-win-1 соблюдает срок пода для обоих базовых образов.
Go переводит CTRL_CLOSE_EVENT, CTRL_LOGOFF_EVENT и CTRL_SHUTDOWN_EVENT в syscall.SIGTERM для каналов os/signal (документация пакета). Поэтому signal.NotifyContext из части 5 работает на Windows без изменений: hello.exe переводит /readyz в 503, дожидается текущих запросов и выходит. Процесс должен завершиться сам: обработчик события лишь даёт отсрочку, после возврата из него система завершает процесс. Удалим под и посмотрим его лог:
$ kubectl -n win-demo logs -f hello-win-759c899954-tkfg6 &
$ date +%T.%N; kubectl -n win-demo delete pod hello-win-759c899954-tkfg6; date +%T.%N
13:07:29.630381395
pod "hello-win-759c899954-tkfg6" deleted from win-demo namespace
{"time":"2026-11-07T13:07:34.6630246+03:00","level":"INFO","msg":"signal received, shutting down"}
{"time":"2026-11-07T13:07:34.6646675+03:00","level":"INFO","msg":"bye"}
13:07:36.352513500
Сигнал пришёл через 5 секунд — столько длился preStop, — и процесс вышел за две миллисекунды. Удаление пода целиком заняло 6,7 секунды: ещё около полутора секунд после выхода процесса HCS останавливал сам контейнер — его системные процессы и окружение. Время это зависит от диска узла: на стенде, пока диски виртуальных машин лежали на HDD, та же остановка занимала 17 секунд, и terminationGracePeriodSeconds для Windows-подов стоит давать с запасом.
preStop. Гонка между удалением пода из EndpointSlice и остановкой процесса та же, что на Linux. Действие sleep в хуке preStop выполняет сам kubelet, поэтому оно не требует ни sleep, ни оболочки в образе.
Выключение узла. Функция Windows graceful node shutdown позволяет kubelet, работающему службой Windows, задержать выключение ОС на shutdownGracePeriod и корректно остановить поды. В 1.37 она в бете и включена по умолчанию — метрика kubelet kubernetes_feature_enabled{name="WindowsGracefulNodeShutdown",stage="BETA"} на нашем узле равна 1, — но действует, только если shutdownGracePeriod не нулевой, а по умолчанию он 0s. Плановое обслуживание всё равно начинают с kubectl drain: только он учитывает PodDisruptionBudget.
Хранилище: CSI на Windows
В части 21 драйвер CSI состоял из контроллера и узлового плагина — DaemonSet, который по вызовам kubelet NodeStageVolume и NodePublishVolume монтирует том на узле. Узловому плагину на Linux нужен привилегированный контейнер: монтирование — операция над системой узла. На Windows привилегированных контейнеров нет, и долгое время задачу решал csi-proxy.
 csi-proxy (прежняя схема)                     HostProcess (текущая схема)
 ┌───────────────────────────────────┐         ┌───────────────────────────────────┐
 │ под узлового плагина              │         │ HostProcess-под узлового плагина  │
 │ обычный Windows-контейнер,        │         │ процессы прямо на узле,           │
 │ без прав на узле                  │         │ NT AUTHORITY\SYSTEM               │
 │        │                          │         │        │                          │
 │        │ gRPC по именованным      │         │        │ вызовы Windows API       │
 │        ▼ каналам \\.\pipe\csi-…   │         │        │ и PowerShell напрямую    │
 │ csi-proxy.exe — служба Windows    │         │        │                          │
 │        │                          │         │        │                          │
 │        ▼                          │         │        ▼                          │
 │ диски, тома, SMB-сопоставления    │         │ диски, тома, SMB-сопоставления    │
 └───────────────────────────────────┘         └───────────────────────────────────┘
csi-proxy — программа, которую ставят на каждый Windows-узел службой. Она открывает набор API для операций с хранилищем — диски, тома, файловая система, SMB, iSCSI — по gRPC (фреймворк удалённого вызова процедур поверх HTTP/2 с описанием методов в Protocol Buffers) через именованные каналы. Узловой плагин в обычном контейнере получает эти каналы как тома и просит csi-proxy сделать то, на что у него самого нет прав. Минусы: ещё одна служба на каждом узле и только те операции, что предусмотрел API csi-proxy.
HostProcess-контейнеры из части 36 сделали посредника необязательным: узловой плагин сам работает как процесс узла, а код csi-proxy превращается в библиотеку Go, которую драйверы встраивают в плагин (репозиторий csi-proxy). Драйверам, ещё не перешедшим на HostProcess, csi-proxy нужен по-прежнему — его можно ставить и HostProcess-DaemonSet'ом.
csi-driver-smb на Windows-узле
csi-driver-smb из части 24 поддерживает Windows-узлы. В основном кластере мы ставили его четырьмя манифестами выпуска для Linux, и Windows-DaemonSet там не нужен. В тестовый кластер поставим тот же выпуск v1.20.4 Helm-чартом (часть 27): в нём по умолчанию windows.enabled: true и windows.useHostProcessContainers: true (параметры чарта) — Windows-DaemonSet на HostProcess-контейнерах, без csi-proxy.
Сначала — то же окружение, что в части 24: неймспейс storage-credentials с Secret smb-files-k8s (учётная запись svc-k8s-smb) и StorageClass smb на шару //files.example.com/k8s — теми же манифестами, только в контексте lab. Отличие одно — toleration для Windows-DaemonSet. Значение по умолчанию рассчитано на taint с ключом node.kubernetes.io/os, а у нас ключ os, и со значениями по умолчанию DaemonSet остался бы без подов. Задаём свою:
# smb-windows-values.yaml
windows:
  tolerations:
  - key: os
    operator: Equal
    value: windows
    effect: NoSchedule
$ helm repo add csi-driver-smb https://raw.githubusercontent.com/kubernetes-csi/csi-driver-smb/master/charts
$ helm --kube-context lab install csi-driver-smb csi-driver-smb/csi-driver-smb -n kube-system --version 1.20.4 \
    -f smb-windows-values.yaml
$ kubectl --context lab -n kube-system get ds -l app.kubernetes.io/instance=csi-driver-smb
NAME               DESIRED   CURRENT   READY   UP-TO-DATE   AVAILABLE   NODE SELECTOR              AGE
csi-smb-node       3         3         3       3            3           kubernetes.io/os=linux     5m28s
csi-smb-node-win   1         1         1       1            1           kubernetes.io/os=windows   5m28s
$ kubectl --context lab -n kube-system get pods -l app=csi-smb-node-win -o wide
NAME                     READY   STATUS    RESTARTS      AGE     IP              NODE
csi-smb-node-win-bwwmx   2/2     Running   0             27s     192.168.10.25   k8s-lab-win-1
Linux-DaemonSet, как в части 24, работает и на control plane, поэтому подов у него три — на мастере и обоих воркерах. У Windows-пода два контейнера: node-driver-registrar и smb (образ smbplugin:v1.20.4-windows-hp), отдельного liveness-probe, как на Linux, нет. IP пода — адрес узла: HostProcess-поды всегда работают в сети узла. На медленном диске node-driver-registrar может спросить имя драйвера раньше, чем тот начнёт отвечать (Error retreiving CSI driver name ... DeadlineExceeded), и один раз перезапуститься — со второй попытки всё регистрируется. Контроллер драйвера работает на Linux-узле, создавать каталоги томов на шаре по-прежнему его работа.
Сервер: ещё четыре адреса
Samba на files.example.com из части 24 пускает только адреса узлов основного кластера — в hosts allow и в правилах ufw. Добавляем узлы тестового: Windows-узел 192.168.10.25 — с него тома монтирует HostProcess-плагин, — и Linux-узлы 192.168.10.23, .24 и .26, где работают контроллер драйвера, который создаёт на шаре каталоги томов, и Linux-плагин:
user@files:~$ sudo grep 'hosts allow' /etc/samba/smb.conf
   hosts allow = 192.168.10.17 192.168.10.20 192.168.10.21 192.168.10.23 192.168.10.24 192.168.10.25 192.168.10.26 127.0.0.1
user@files:~$ sudo smbcontrol smbd reload-config
user@files:~$ for ip in 192.168.10.23 192.168.10.24 192.168.10.25 192.168.10.26; do
>   sudo ufw allow from $ip to any port 445 proto tcp comment 'SMB: k8s nodes'
> done
smbcontrol smbd reload-config перечитывает конфигурацию без перезапуска smbd и без разрыва сессий узлов основного кластера. Сама шара, учётная запись svc-k8s-smb и её права остаются такими, как в части 24. Политика Calico из частей 22 и 24, запрещающая подам ходить на файловые серверы напрямую, живёт в основном кластере; в тестовом её стоит повторить, и Windows-узлу она не помешает: монтирует HostProcess-плагин из сети узла, а не под.
Том в Windows-поде
В самом Windows-поде том подключается как обычно — persistentVolumeClaim в volumes и путь Windows в mountPath. Пишущий под — на голом nanoserver, раз в 10 секунд дописывает в файл на томе текущее время:
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: reports
  namespace: win-demo
spec:
  accessModes: ["ReadWriteMany"]
  storageClassName: smb
  resources:
    requests:
      storage: 1Gi
---
apiVersion: apps/v1
kind: Deployment
metadata:
  name: reports-writer
  namespace: win-demo
spec:
  replicas: 1
  selector:
    matchLabels:
      app.kubernetes.io/name: reports-writer
  template:
    metadata:
      labels:
        app.kubernetes.io/name: reports-writer
    spec:
      os:
        name: windows
      runtimeClassName: windows-2025
      securityContext:
        runAsNonRoot: true
        windowsOptions:
          runAsUserName: ContainerUser
      containers:
      - name: writer
        image: mcr.microsoft.com/windows/nanoserver:ltsc2025
        command:
        - cmd
        - /v:on
        - /c
        - "for /l %i in (0,0,1) do (echo !date! !time! >> C:\\data\\visits.log & ping -n 11 127.0.0.1 >nul)"
        volumeMounts:
        - name: reports
          mountPath: C:\data
        resources:
          requests: { cpu: 50m, memory: 64Mi }
          limits: { cpu: 200m, memory: 128Mi }
      volumes:
      - name: reports
        persistentVolumeClaim:
          claimName: reports
for /l %i in (0,0,1) — бесконечный цикл cmd.exe, а ping -n 11 на петлевой адрес — пауза в 10 секунд: в nanoserver нет timeout.exe. Ключ /v:on включает отложенное раскрытие переменных: cmd подставляет %time% один раз, когда читает всю строку цикла, и без него каждая строка файла содержала бы одно и то же время; !time! раскрывается на каждом шаге.
$ kubectl apply -f reports.yaml
persistentvolumeclaim/reports created
deployment.apps/reports-writer created
$ kubectl -n win-demo get pvc reports
NAME      STATUS   VOLUME                                     CAPACITY   ACCESS MODES   STORAGECLASS   VOLUMEATTRIBUTESCLASS   AGE
reports   Bound    pvc-ea3d8e0f-a51d-4662-9e44-b9174787e9a2   1Gi        RWX            smb            <unset>                 5s
$ kubectl -n win-demo exec deploy/reports-writer -- cmd /c "type C:\data\visits.log"
Sat 11/07/2026 11:32:00.71
Sat 11/07/2026 11:32:10.82
Sat 11/07/2026 11:32:20.91
Как монтируется SMB-том на Windows
На Linux узловой плагин вызывал mount -t cifs. На Windows используется SMB global mapping — возможность клиента SMB Windows подключить шару на уровне всего узла, а не сеанса пользователя (документация Microsoft). В логе плагина на Windows-узле это видно по шагам:
$ kubectl -n kube-system logs csi-smb-node-win-tmwv5 -c smb | grep -E 'NewSmbGlobalMapping|NodePublishVolume: mount'
I1107 12:50:41.289414    3084 smb.go:108] begin to run NewSmbGlobalMapping with \\files.example.com\k8s\win-demo-reports-pvc-ea3d8e0f-a51d-4662-9e44-b9174787e9a2, AZURE\svc-k8s-smb, requirePrivacy=true
I1107 12:50:42.264444    3084 nodeserver.go:133] NodePublishVolume: mount \var\lib\kubelet\plugins\kubernetes.io\csi\smb.csi.k8s.io\baecf4ef08a658e21cb8545a32bc8fa6d0e686b7609dd86a15c949060a26e442\globalmount at c:\var\lib\kubelet\pods\5530838f-65a3-41a2-a236-3c88c4634121\volumes\kubernetes.io~csi\pvc-ea3d8e0f-a51d-4662-9e44-b9174787e9a2\mount volumeID(files.example.com/k8s#win-demo-reports-pvc-ea3d8e0f-a51d-4662-9e44-b9174787e9a2#pvc-ea3d8e0f-a51d-4662-9e44-b9174787e9a2#archive) successfully
- NodeStage. Плагин вызывает
New-SmbGlobalMappingс путём\\files.example.com\k8s\<каталог тома>и учётными данными из Secretsmb-files-k8s; флаг-RequirePrivacy(параметр чартаwindows.requirePrivacyForGlobalMapping, по умолчанию включён) требует шифрования SMB3 — аналог опцииsealна Linux. Затем создаётся символическая ссылкаC:\var\lib\kubelet\plugins\kubernetes.io\csi\smb.csi.k8s.io\<хеш>\globalmount, указывающая на сетевой путь. Хеш, как и на Linux, — SHA-256 отvolumeHandle. - NodePublish. В каталоге тома пода появляется ещё одна ссылка — на
globalmount, а containerd подключает её в контейнер по пути изmountPath. - NodeUnstage. Ссылка удаляется, а с ней и сопоставление (
windows.removeSMBMappingDuringUnmount: trueв чарте).
Обратите внимание на AZURE\svc-k8s-smb: Windows-плагин передаёт учётную запись в виде ДОМЕН\имя и, если в Secret нет поля domain, подставляет домен AZURE — наследство проекта, начинавшегося с Azure Files. Samba в роли отдельного сервера домен в учётных данных игнорирует, поэтому том смонтировался. Windows-серверу в домене нужен настоящий домен — поле domain: EXAMPLE в Secret, как сказано в части 24.
Отличия от Linux, которые надо знать:
mountOptionsкласса не действуют. Из всех параметров монтирования Windows-плагин берёт только учётную запись и пароль;vers,dir_mode,file_mode,uid,nobrl,nolease,hard— опции модуля cifs Linux, у клиента Windows их нет, и в логе плагина при монтировании их нет. Один StorageClasssmbгодится для обеих ОС: Linux-узлы применят опции, Windows-узлы их пропустят.- Права решает сервер. Всё, что процесс в контейнере делает с файлами тома, сервер видит как действия
svc-k8s-smb: Samba создаёт файлы от этого пользователя с режимами изcreate maskиdirectory mask. Эмуляции владельца и режима файлов, как у cifs, нет, аfsGroupв Windows-поде запрещён. Разграничивать доступ между приложениями приходится разными учётными записями и шарами. - Сопоставление видно всему узлу: по документации Microsoft, доступ к шаре получает любой процесс на узле. Обычный контейнер видит только свой каталог, а любой HostProcess-под — весь каталог тома на сервере.
- Блокировки. Клиент Windows соблюдает принудительные байтовые блокировки SMB, а Linux-поды с
nobrlиз части 24 держат блокировки только у себя. Если один и тот же файл пишут поды на Linux и на Windows, блокировки между ними не действуют.
NFS — только на Linux-узлах
У csi-driver-nfs из части 23 Windows-плагина нет. В Windows Server есть свой клиент NFS, но драйвер им не пользуется, а NFS-сервер из части 22 закрыт для всех, кроме Linux-узлов основного кластера. В тестовый кластер мы csi-driver-nfs не ставим, но правило касается любого гибридного кластера, где он есть. Если Windows-под попросит NFS-том, планировщик его разместит — он не знает, какие драйверы зарегистрированы на узле, — а kubelet не сможет смонтировать. Проверим на статическом PV драйвера nfs.csi.k8s.io и объекте CSIDriver — том, что создаёт установка драйвера (attachRequired: false), — но без самого драйвера, как его видит Windows-узел в кластере, где драйвер работает только на Linux:
$ kubectl -n win-demo describe pod nfs-win-test | tail -1
  Warning  FailedMount  36s (x8 over 100s)  kubelet  MountVolume.MountDevice failed for volume "nfs-win-test" : kubernetes.io/csi: attacher.MountDevice failed to create newCsiDriverClient: driver name nfs.csi.k8s.io not found in the list of registered CSI drivers
Под так и остаётся в ContainerCreating. Без объекта CSIDriver ошибка была бы другой — timed out waiting for external-attacher of nfs.csi.k8s.io CSI driver: не зная драйвера, Kubernetes считает, что тому нужен шаг подключения к узлу, и ждёт сайдкар attacher, которого нет. Правило для гибридного кластера: Windows-приложениям — SMB, NFS — только подам на Linux. Данные, которые нужны обеим ОС, кладут на SMB-шару.
Логи: stdout, журнал событий, ETW и LogMonitor
Для контейнера, который пишет в stdout и stderr, на Windows ничего не меняется: containerd пишет потоки в файлы в формате CRI из части 33, только путь — C:\var\log\pods\<неймспейс>_<под>_<uid>\<контейнер>\0.log, kubelet так же их ротирует, kubectl logs так же работает. hello.exe пишет JSON-строки slog в stdout, и его логи ничем не отличаются от Linux-варианта.
Проблема в том, что традиционные Windows-программы в stdout почти ничего не пишут. Их каналы журналирования другие:
- Журнал событий Windows (Event Log) — системная служба, принимающая структурированные записи от программ и служб. Записи разложены по каналам (
System,Application, отдельные каналы компонентов вродеMicrosoft-Windows-Host-Network-Service-Admin), у каждой есть источник, код события (Event ID), уровень (ошибка, предупреждение, сведения) и время. Читают егоGet-WinEventили «Просмотр событий». - ETW (Event Tracing for Windows) — механизм трассировки уровня ядра. Компоненты-провайдеры (их сотни: IIS, рантайм .NET, сетевой стек, HNS) объявляют события и пишут их, только если кто-то слушает. Сеанс трассировки включает нужных провайдеров с заданным уровнем подробности и собирает события в буферы, откуда их читает потребитель — в файл или в реальном времени. Выключенный провайдер почти ничего не стоит, поэтому ETW встроен везде.
- Файлы — IIS пишет журнал запросов в
C:\inetpub\logs\LogFilesв формате W3C, многие приложения — свои текстовые журналы.
Ничего из этого containerd не увидит. Мост между ними и stdout — LogMonitor, утилита Microsoft (репозиторий), которая работает внутри контейнера: запускает приложение дочерним процессом, подписывается на указанные каналы журнала событий и провайдеры ETW, следит за файлами и всё это печатает в свой stdout, по умолчанию в JSON. Конфигурация лежит в C:\LogMonitor\LogMonitorConfig.json. Типичный пример — IIS на servercore, тот самый тяжёлый образ, который в этом блоке мы не запускаем:
{
  "LogConfig": {
    "logFormat": "json",
    "sources": [
      {
        "type": "EventLog",
        "startAtOldestRecord": true,
        "eventFormatMultiLine": false,
        "channels": [
          { "name": "system", "level": "Warning" },
          { "name": "application", "level": "Error" }
        ]
      },
      {
        "type": "File",
        "directory": "C:\\inetpub\\logs",
        "filter": "*.log",
        "includeSubdirectories": true
      }
    ]
  }
}
Источник ETW описывается так же — списком провайдеров с именем, GUID и уровнем. Dockerfile образа IIS с LogMonitor:
FROM mcr.microsoft.com/windows/servercore/iis:windowsservercore-ltsc2025
COPY LogMonitor.exe LogMonitorConfig.json C:/LogMonitor/
COPY site/ C:/inetpub/wwwroot/
ENTRYPOINT ["C:\\LogMonitor\\LogMonitor.exe", "C:\\ServiceMonitor.exe", "w3svc"]
Цепочка запуска: LogMonitor запускает ServiceMonitor.exe из образа IIS, тот запускает службу W3SVC и следит за ней — контейнер живёт, пока работает служба, — а LogMonitor пересылает журналы. LogMonitor.exe берут из релизов репозитория (на момент написания стабильная версия — 2.2.1) и кладут в контекст сборки, сверив контрольную сумму. В этом Dockerfile тоже нет RUN, и его можно собрать на Linux, как hello. Оговорка: IIS пишет журнал запросов в файл с буферизацией, так что строки появляются в stdout с задержкой до минуты.
Loki и Alloy для Windows-узла
В основном кластере логи собирает Loki из части 33. Тестовый кластер получает свой: так блок не трогает основной кластер, а неймспейсы и поды двух кластеров не смешиваются в одних запросах. Alloy-DaemonSet из части 33 Windows-узлу не подошёл бы: его образ — Linux, а файлы Windows-узла ему не видны. На Windows-узле нужен свой экземпляр, и удобнее всего — HostProcess-под: процесс Alloy работает прямо на узле, читает C:\var\log\pods как обычные файлы и заодно может читать журнал событий самого узла.
 k8s-lab-win-1
 ┌──────────────────────────────────────────────────────────────┐
 │ под hello-win: hello.exe ───────────────────────────► stdout │
 │ под с LogMonitor: журнал событий, файлы ────────────► stdout │
 │                                                          │   │
 │                       containerd ◄───────────────────────┘   │
 │                           │                                  │
 │                           ▼                                  │
 │ C:\var\log\pods\<ns>_<под>_<uid>\<контейнер>\0.log           │
 │                           │                                  │
 │                           ▼                                  │
 │ Alloy (HostProcess) ◄──── журнал событий узла: System        │
 └───────────────────────────┼──────────────────────────────────┘
                             │ HTTP: 192.168.10.24:31100 (NodePort)
                             ▼
 Linux-узлы: kube-proxy ──► loki-gateway ──► Loki
Loki в тестовом кластере
Сначала неймспейс monitoring с уровнем privileged Pod Security Admission: и Alloy, и windows-exporter ниже — HostProcess-поды, а node-exporter монтирует каталоги узла и работает в его сети.
$ kubectl --context lab create namespace monitoring
$ kubectl --context lab label namespace monitoring pod-security.kubernetes.io/enforce=privileged
Loki ставится тем же чартом и в том же режиме Monolithic, что в части 33. Values — loki-values.yaml оттуда с отличиями:
# loki-lab-values.yaml: loki-values.yaml из части 33, где
# - вместо S3 файловая система пода: S3 и local-path в тестовом кластере нет;
# - retention_period: 3d;
# - gateway опубликован на NodePort для Windows-узла
loki:
  schemaConfig:
    configs:
    - from: "2026-10-01"
      store: tsdb
      object_store: filesystem
      schema: v13
      index:
        prefix: loki_index_
        period: 24h
  storage:
    type: filesystem
  limits_config:
    retention_period: 3d
    allow_structured_metadata: true
  compactor:
    retention_enabled: true
    delete_request_store: filesystem

singleBinary:
  replicas: 1
  persistence:
    enabled: false

gateway:
  service:
    type: NodePort
    nodePort: 31100
$ helm --kube-context lab install loki oci://ghcr.io/grafana-community/helm-charts/loki \
    --version 20.4.1 -n monitoring -f loki-lab-values.yaml
...
STATUS: deployed
$ kubectl --context lab -n monitoring get pods,svc -l app.kubernetes.io/instance=loki -o wide | grep -E 'NAME|loki-0|gateway'
NAME                               READY   STATUS    RESTARTS   AGE   IP              NODE
pod/loki-0                         2/2     Running   0          78s   172.21.211.27   k8s-lab-node-1
pod/loki-gateway-cd47c7dc8-k5fx8   2/2     Running   0          78s   172.21.172.13   k8s-lab-node-2
NAME                            TYPE        CLUSTER-IP       EXTERNAL-IP   PORT(S)                      AGE
service/loki-gateway            NodePort    10.106.213.144   <none>        80:31100/TCP                 79s
Данные Loki живут в emptyDir пода и пропадают при его пересоздании — для стенда это приемлемо.
Почему NodePort. HostProcess-под живёт в сети узла: кластерный DNS ему не виден, имя loki-gateway.monitoring.svc не разрешается, а к адресам сервисов Windows-хост не обращается вовсе — их балансирует VFP на портах подов, а не на самом хосте (это мы видели в части 38). Нужен адрес, доступный узлу как обычной машине. NodePort из части 15 — порт 31100 на каждом Linux-узле, который kube-proxy ведёт к loki-gateway, — именно такой адрес. Alloy пишет на 192.168.10.24:31100; на время обслуживания k8s-lab-node-1 адрес меняют на соседний узел. В рабочем кластере здесь был бы адрес балансировщика MetalLB из части 17 или имя Ingress с TLS, как у сервисов основного кластера.
Образ Alloy для HostProcess
Образ HostProcess-контейнера не обязан совпадать по версии с узлом: его файлы просто подключаются к процессу на узле (документация Kubernetes). Поэтому образ собирается на минимальной базе для HostProcess и содержит один исполняемый файл Alloy для Windows из релизов Grafana, сверенный по SHA256SUMS выпуска:
$ gh release download v1.21.3 -R grafana/alloy -p 'alloy-windows-amd64.exe.zip' -p SHA256SUMS
$ grep ' alloy-windows-amd64.exe.zip$' SHA256SUMS | sha256sum -c -
alloy-windows-amd64.exe.zip: OK
$ unzip alloy-windows-amd64.exe.zip
FROM mcr.microsoft.com/oss/kubernetes/windows-host-process-containers-base-image:v1.0.0
COPY alloy-windows-amd64.exe /alloy/alloy.exe
$ docker buildx build --platform windows/amd64 \
    -t ghcr.io/example/alloy-hostprocess:v1.21.3 --push .
$ docker buildx imagetools inspect ghcr.io/example/alloy-hostprocess:v1.21.3 --raw | \
    jq -c '.manifests[] | .platform' | grep -v unknown
{"architecture":"amd64","os":"windows"}
У этого варианта нет os.version: у базового образа HostProcess его нет, и для HostProcess он не нужен — containerd подходит любой Windows-вариант. Сам alloy.exe весит 415 МБ, это почти весь образ.
Конфигурация и DaemonSet
Конфигурация — та же, что в части 33 (discovery.kubernetes, discovery.relabel, local.file_match, loki.source.file, loki.process со stage.cri), с такими отличиями:
discovery.kubernetes "pods" {
  role = "pod"
  selectors {
    role  = "pod"
    // hostname Windows-узла пишется заглавными (K8S-LAB-WIN-1) и не совпадает
    // с именем объекта Node, поэтому имя берётся из переменной NODE_NAME
    field = "spec.nodeName=" + sys.env("NODE_NAME")
  }
}

// в discovery.relabel — путь Windows вместо /var/log/pods
  rule {
    source_labels = ["__meta_kubernetes_pod_uid", "__meta_kubernetes_pod_container_name"]
    separator     = "\\"
    target_label  = "__path__"
    replacement   = "C:\\var\\log\\pods\\*$1\\*.log"
  }

// критические события, ошибки и предупреждения журнала System узла
loki.source.windowsevent "system" {
  eventlog_name = "System"
  xpath_query   = "*[System[(Level=1 or Level=2 or Level=3)]]"
  labels        = { job = "windows-events", node = sys.env("NODE_NAME") }
  forward_to    = [loki.write.default.receiver]
}

// gateway Loki на NodePort Linux-узла
loki.write "default" {
  endpoint {
    url = "http://192.168.10.24:31100/loki/api/v1/push"
  }
}
loki.source.windowsevent подписывается на канал журнала событий и превращает каждую запись в JSON-строку с источником, кодом события и текстом; запрос XPath отбирает уровни 1–3 — критические, ошибки и предупреждения. В канал System пишут, например, служба HNS и диспетчер служб, когда падают kubelet или containerd.
Alloy ставится DaemonSet'ом alloy-windows в неймспейсе monitoring. Helm-релиза Alloy в тестовом кластере нет, поэтому ServiceAccount alloy-windows с ClusterRole на get, list и watch подов — те права, что в части 33 создавал чарт, — кладём рядом с DaemonSet, а образ из частного пакета ghcr.io скачивается с тем же Secret ghcr-pull, скопированным в monitoring и указанным в imagePullSecrets ServiceAccount. Главное в спецификации пода:
    spec:
      os: { name: windows }
      nodeSelector: { kubernetes.io/os: windows }
      tolerations:
      - { key: os, operator: Equal, value: windows, effect: NoSchedule }
      serviceAccountName: alloy-windows   # чтение подов через API
      hostNetwork: true
      securityContext:
        windowsOptions:
          hostProcess: true
          runAsUserName: "NT AUTHORITY\\SYSTEM"
      containers:
      - name: alloy
        image: ghcr.io/example/alloy-hostprocess:v1.21.3
        command: ["alloy\\alloy.exe"]
        args: ["run", "C:\\etc\\alloy\\config.alloy", "--storage.path=C:\\var\\lib\\alloy",
               "--server.http.listen-addr=127.0.0.1:12345"]
        env:
        - name: NODE_NAME
          valueFrom: { fieldRef: { fieldPath: spec.nodeName } }
        - name: KUBERNETES_SERVICE_HOST     # адрес сервиса kubernetes из сети
          value: k8s-lab-api.example.com    # Windows-узла недоступен
        - name: KUBERNETES_SERVICE_PORT
          value: "6443"
        resources:
          requests: { cpu: 50m, memory: 128Mi }
          limits: { memory: 512Mi }
        volumeMounts:
        - name: config                      # ConfigMap alloy-windows с config.alloy
          mountPath: C:\etc\alloy
NT AUTHORITY\SYSTEM— встроенная учётная запись LocalSystem с полными правами на узле: менее привилегированныеLocalServiceиNetworkServiceне могут читатьC:\var\log\pods. Такой под разрешён только потому, что неймспейсmonitoringработает на уровнеprivileged.KUBERNETES_SERVICE_HOSTиKUBERNETES_SERVICE_PORT— клиент API Kubernetes внутри Alloy по умолчанию идёт на адрес сервисаkubernetes, а из сети Windows-узла он недоступен; так же Tigera operator через ConfigMapkubernetes-services-endpointнастраивает свои компоненты на Windows. Токен ServiceAccount и ConfigMap HostProcess-процесс видит по обычным путям —C:\var\run\secrets\kubernetes.io\serviceaccountиC:\etc\alloy: containerd 2.x подключает тома HostProcess-контейнера через фильтр привязки (bind filter) прямо в файловую систему узла.command: alloy\alloy.exe— относительный путь: рабочий каталог HostProcess-контейнера — каталог, куда HCS подключил содержимое образа (C:\hpc, как у Calico в части 38).--storage.path— позиции чтения файлов и закладки журнала событий прямо на диске узла: позиции переживают перезапуск пода, и строки не дублируются.127.0.0.1:12345— HTTP-интерфейс Alloy только на петлевом адресе, иначе в сети узла он открылся бы всем.
$ kubectl --context lab apply -f alloy-windows.yaml
serviceaccount/alloy-windows created
clusterrole.rbac.authorization.k8s.io/alloy-windows created
clusterrolebinding.rbac.authorization.k8s.io/alloy-windows created
configmap/alloy-windows created
daemonset.apps/alloy-windows created
$ kubectl --context lab -n monitoring logs ds/alloy-windows | grep -m3 'start tailing'
ts=2026-11-07T08:57:28.4349168Z level=info msg="start tailing file" component_path=/ component_id=loki.source.file.pods component=tailer path=C:\var\log\pods\kube-system_csi-smb-node-win-tmwv5_67edd1e6-61c9-4bad-bfa9-6e38b204bfba\node-driver-registrar\1.log
ts=2026-11-07T08:57:28.466877Z level=info msg="start tailing file" component_path=/ component_id=loki.source.file.pods component=tailer path=C:\var\log\pods\win-demo_hello-win-8658cc7d9-gt5sn_78b25d8a-e73a-49e5-bade-f103d330292c\hello\0.log
ts=2026-11-07T08:57:28.4723825Z level=info msg="start tailing file" component_path=/ component_id=loki.source.file.pods component=tailer path=C:\var\log\pods\win-demo_reports-writer-67b96b59b-g9wrq_177700c4-ab4c-4c66-85d6-3616e2dabd40\writer\0.log
Пути с обратной косой чертой Alloy понимает, а файлы читает с конца, как в части 33. Как логи выглядят в Loki — в «Смотрим руками».
Вместо Alloy можно взять Fluent Bit: у него есть сборки для Windows, вход для журнала событий и выход в Loki, и ставится он таким же HostProcess-DaemonSet'ом.
Метрики: kubectl top и windows-exporter
Контур ресурсов из части 32 на Windows работает без изменений (metrics-server в тестовый кластер поставлен в части 38): kubelet получает статистику контейнеров от containerd по CRI, metrics-server опрашивает его /metrics/resource, kubectl top и HPA видят Windows-поды наравне с остальными. Проценты HPA считаются от requests, как и на Linux, хотя ядро Windows про requests ничего не знает.
Полный контур — другое дело. Метрики cAdvisor container_*, на которых построены дашборды и правила kube-prometheus-stack, cAdvisor собирает из cgroups, которых на Windows нет. node-exporter — Linux-программа, читающая /proc и /sys. На Windows-узле их место занимает windows-exporter (репозиторий) — экспортёр Prometheus, который собирает данные из счётчиков производительности и WMI (Windows Management Instrumentation — интерфейс Windows для запроса сведений о системе) и отдаёт их на порту 9182. Сборщик container берёт статистику Windows-контейнеров у HCS и подписывает её именами пода и контейнера, которые узнаёт у containerd по CRI.
В kube-prometheus-stack он включается одним параметром. Самого kube-prometheus-stack в тестовом кластере пока нет, и ставится он так же, как в части 32: тот же чарт той же версии, неймспейс monitoring (он уже создан для Loki), Secret grafana-admin. Values — kps-values.yaml из части 32 с отличиями:
# kps-lab-values.yaml: kps-values.yaml из части 32, где
# - у prometheusSpec и alertmanagerSpec убраны storageSpec и storage:
#   local-path-provisioner из части 25 в тестовом кластере нет, данные в emptyDir;
# - retention: 3d, retentionSize убран;
# и добавлены источник данных Loki и метрики Windows-узлов
grafana:
  additionalDataSources:
  - name: Loki
    uid: loki
    type: loki
    url: http://loki-gateway.monitoring.svc
windowsMonitoring:
  enabled: true
$ kubectl --context lab create secret generic grafana-admin -n monitoring \
    --from-literal=admin-user=admin --from-literal=admin-password="$(openssl rand -base64 24)"
$ helm --kube-context lab install kps oci://ghcr.io/prometheus-community/charts/kube-prometheus-stack \
    --version 92.17.1 -n monitoring -f kps-lab-values.yaml
$ kubectl --context lab -n monitoring get ds
NAME                              DESIRED   CURRENT   READY   UP-TO-DATE   AVAILABLE   NODE SELECTOR              AGE
kps-prometheus-node-exporter      3         3         3       3            3           kubernetes.io/os=linux     11m
kps-prometheus-windows-exporter   1         1         1       1            1           kubernetes.io/os=windows   11m
При старте Grafana пытается скачать плагины с grafana.com; из нашей сети тот отвечал HTTP 451, и в журнале Grafana остаются ошибки Failed to install plugin, но работает она и без них. История метрик тестового кластера живёт в emptyDir и пропадает при пересоздании пода Prometheus — для стенда это приемлемо. Grafana открывается через kubectl --context lab port-forward -n monitoring svc/kps-grafana 3000:80: Ingress-контроллера в тестовом кластере нет.
Параметр windowsMonitoring.enabled ставит вложенный чарт prometheus-windows-exporter — HostProcess-DaemonSet windows-exporter 0.31.9 от имени NT AUTHORITY\system с толерантностью ко всем taint NoSchedule и сборщиками по умолчанию плюс memory и container, ServiceMonitor с заданием windows-exporter — и правила и дашборды Grafana для Windows-узлов, рассчитанные на это имя задания.
Дашборды для Windows отдельные, у них в названии (Windows): «Kubernetes / Compute Resources / Cluster(Windows)», «Namespace(Windows)», «Pod(Windows)» и два дашборда USE Method. Память на них — Private Working Set из метрик windows-exporter, а не cgroups. Так выглядит «Namespace(Windows)» для win-demo за три часа работы с этой частью: провалы на графике памяти — перезагрузки и аварийное выключение узла из раздела об обновлении Windows-узлов ниже, а после каждого из них поды aspnetapp получают новые имена:
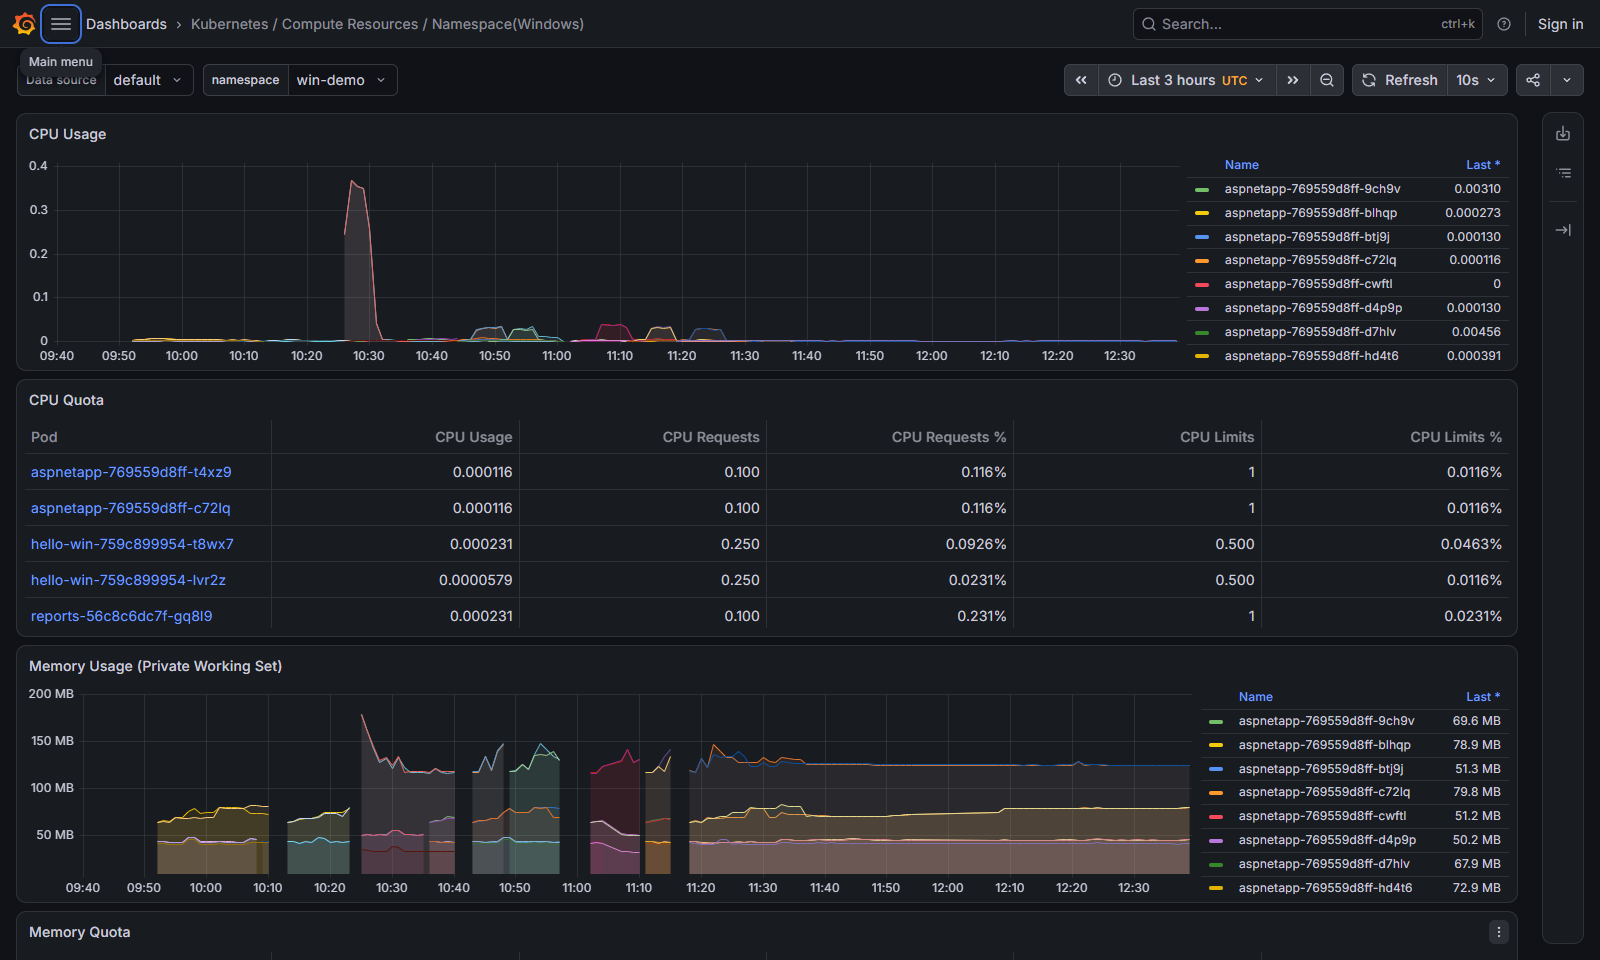
Порт 9182 и файрвол
Prometheus ходит на 192.168.10.25:9182, и файрвол Windows этот порт по умолчанию закрывает. Чарт решает это сам, и не самым аккуратным образом — init-контейнером:
$ kubectl --context lab -n monitoring get ds kps-prometheus-windows-exporter \
    -o jsonpath='{.spec.template.spec.initContainers[0].args}'
["New-NetFirewallRule","-DisplayName","'windows-exporter'","-Direction","inbound","-Profile","Any","-Action","Allow","-LocalPort","9182","-Protocol","TCP"]
Правило открывает 9182 всем адресам, и New-NetFirewallRule создаёт новое при каждом запуске пода: после одного пересоздания пода правил стало два, и так дальше. Отключить init-контейнер параметром чарта нельзя. Метрики узла — не пароли, но список процессов, служб и сетевых адресов посторонним знать незачем. Сузить доступ помогает то, что в файрволе Windows запрещающее правило сильнее разрешающего: добавляем правило Block для всех адресов, кроме узлов кластера.
PS C:\> New-NetFirewallRule -Name windows-exporter-block-others -DisplayName 'windows-exporter: only k8s nodes' `
          -Direction Inbound -Protocol TCP -LocalPort 9182 -Action Block `
          -RemoteAddress '0.0.0.0-192.168.10.22','192.168.10.27-255.255.255.255'
Разрешёнными остаются 192.168.10.23–.26: Linux-узлы — Calico подменяет адрес источника на адрес узла, когда пакет пода уходит за пределы сети подов, и запрос Prometheus приходит с адреса Linux-узла, где тот работает, — и сам Windows-узел. Последнее легко упустить: пробы readinessProbe и livenessProbe windows-exporter kubelet выполняет с адреса узла. На стенде первая версия правила закрыла и его — пробы стали падать по тайм-ауту, kubelet перезапускал контейнер, и под ушёл в CrashLoopBackOff.
Полезные запросы
Имена метрик Windows отличаются от Linux, и не все с суффиксом единиц: предел выделения памяти — windows_memory_commit_limit, без _bytes. А у метрик контейнеров метки namespace, pod и container заняты метками самой цели — пода windows-exporter, — и Prometheus переименовал метки контейнера в exported_namespace, exported_pod и exported_container. kube-prometheus-stack на этот случай ставит правила записи (kps-windows.pod.rules): windows_container_memory_usage и windows_container_private_working_set_usage — те же значения с настоящими метками пода, взятыми из kube_pod_container_info.
# загрузка CPU узла, %
100 - avg by (instance) (rate(windows_cpu_time_total{mode="idle"}[5m])) * 100

# выделенная память относительно предела выделения — главный показатель памяти Windows
windows_memory_committed_bytes / windows_memory_commit_limit

# выделенная и рабочая память контейнеров hello-win
windows_container_memory_usage{namespace="win-demo", pod=~"hello-win-.*"}
windows_container_private_working_set_usage{namespace="win-demo", pod=~"hello-win-.*"}

# выделенная память контейнера относительно его лимита
windows_container_memory_usage / on (namespace, pod, container) kube_pod_windows_container_resource_memory_limit

# службы узла
windows_service_state{name=~"kubelet|containerd", state="running"}
На стенде, с двумя подами hello-win, aspnetapp и reports-writer на узле, они дают вот что:
| Запрос | Значение |
|---|---|
| загрузка CPU узла | 5,4 % |
| выделенная память узла относительно предела | 0,31 |
выделенная память контейнера hello-win |
98 МиБ |
| рабочая память того же контейнера | 42 МиБ |
| выделенная память относительно лимита 256 МиБ | 0,38 |
kubelet и containerd в состоянии running |
1 и 1 |
Выделенная память контейнера больше чем вдвое превышает рабочую — и kubectl top показывает именно рабочую (41 МиБ). Лимит же job object считает выделенную, поэтому до него у hello-win гораздо ближе, чем кажется по kubectl top.
Раз на Windows нет OOM killer, самые полезные правила алертов — о памяти. windows_memory_committed_bytes / windows_memory_commit_limit > 0.9 предупреждает, что узел вот-вот начнёт отказывать в выделении памяти всем контейнерам сразу, а до этого уйдёт в подкачку. Отношение выделенной памяти контейнера к лимиту выше 0,9 — предвестник того отказа VirtualAlloc, который мы видели выше, и падения с кодом выхода вместо OOMKilled. Оба выражения кладут в PrometheusRule, как в части 32.
Обновление Windows-узлов
Ежемесячные обновления
Microsoft выпускает обновления безопасности Windows во второй вторник месяца (выпуск «B», «вторник обновлений»). В тот же день в MCR выходят пересобранные базовые образы: обновлять Windows изнутри контейнера нельзя, у образа нет механизма обслуживания, поэтому каждый месяц Microsoft пересобирает nanoserver:ltsc2025 и servercore:ltsc2025 целиком (документация Microsoft). Отсюда два независимых потока работ:
 второй вторник месяца
   │
   ├─► MCR: новые nanoserver:ltsc2025, servercore:ltsc2025
   │      └─► Renovate обновляет дайджест базы, CI собирает hello:1.3.1,
   │          раскатка обычным обновлением Deployment
   │
   └─► k8s-lab-win-1: drain → установка обновлений → перезагрузка
                      → проверка → uncordon
Совпадение revision не требуется. Для Windows Server 2019 и новее узел и образ с разными месячными обновлениями совместимы: важна сборка, а не revision, — наш hello:1.3 с базой 26100.33674 работает на узле 26100.33438. Но и пересборку образов, и обновление узла делают каждый месяц: дыры закрываются в обоих местах, системные библиотеки в контейнере — не те, что на узле. Пиннинг базы по дайджесту и бот, обновляющий его, — из части 5.
Узел. Порядок тот же, что для Linux в части 35, с поправкой: Windows-узел у нас один. Выселенным подам hello-win некуда идти — они будут Pending, пока узел не вернётся, а PodDisruptionBudget minAvailable: 1, как у hello, вовсе не дал бы drain выселить вторую реплику. Приложениям, которые должны переживать обслуживание, нужно минимум два Windows-узла; в тестовом кластере с одним Windows-узлом обслуживание — окно простоя Windows-подов.
Обновления на Server Core ставят через меню sconfig или централизованно через WSUS и групповые политики (о них — в части 24 серии «Windows Server для самых маленьких»). Главное — запретить автоматическую перезагрузку: Windows Update, перезагрузивший узел без drain, роняет поды. Узел ставят в режим «скачать и уведомить» (в части 38 мы переключили sconfig в Manual), а перезагружают сами:
$ kubectl drain k8s-lab-win-1 --ignore-daemonsets --delete-emptydir-data --timeout=10m
Warning: ignoring DaemonSet-managed Pods: calico-system/calico-node-windows-q54h2, kube-system/csi-smb-node-win-tmwv5, kube-system/kube-proxy-windows-z9qdq, monitoring/alloy-windows-f6ns9, monitoring/kps-prometheus-windows-exporter-l45kh
evicting pod win-demo/reports-writer-67b96b59b-g9wrq
evicting pod win-demo/aspnetapp-769559d8ff-vk445
evicting pod win-demo/aspnetapp-769559d8ff-dkp9z
evicting pod win-demo/hello-win-759c899954-9g74w
evicting pod win-demo/hello-win-759c899954-vwdq6
...
node/k8s-lab-win-1 drained
$ kubectl -n win-demo get pods
NAME                             READY   STATUS    RESTARTS   AGE
aspnetapp-769559d8ff-hd4t6       0/1     Pending   0          36s
aspnetapp-769559d8ff-xk5d5       0/1     Pending   0          36s
hello-win-759c899954-tkfg6       0/1     Pending   0          36s
hello-win-759c899954-tq5nc       0/1     Pending   0          35s
reports-writer-67b96b59b-rfb6z   0/1     Pending   0          36s
PS C:\> sconfig                     # пункт «Install updates», все обновления
PS C:\> Test-Path 'HKLM:\SOFTWARE\Microsoft\Windows\CurrentVersion\WindowsUpdate\Auto Update\RebootRequired'
True
PS C:\> Restart-Computer
После перезагрузки службы containerd и kubelet стартуют сами, DaemonSet'ы перезапускают HostProcess-поды Calico, kube-proxy, csi-driver-smb, Alloy и windows-exporter, а Calico заново создаёт сеть HNS. На стенде с дисками на SSD containerd запустился через 3 секунды после загрузки, kubelet — через 5, и уже через 10 секунд после Restart-Computer узел снова отчитывался в API.
Пока диски виртуальных машин стенда лежали на HDD, было иначе: узел пятнадцать минут оставался NotReady, а в журнале System нашлось вот что:
PS C:\> Get-WinEvent -FilterHashtable @{LogName='System'; ProviderName='Service Control Manager'} -MaxEvents 30 |
          Where-Object Id -in 7000,7001,7009 | Format-Table TimeCreated, Id, Message -Wrap

TimeCreated             Id Message
-----------             -- -------
11/7/2026 12:11:19 PM 7009 A timeout was reached (45000 milliseconds) while waiting for the containerd service to connect.
11/7/2026 12:11:19 PM 7000 The containerd service failed to start due to the following error:
                           The service did not respond to the start or control request in a timely fashion.
11/7/2026 12:11:19 PM 7001 The kubelet service depends on the containerd service which failed to start because of the following error:
                           The operation completed successfully.
SCM ждёт ответа службы при запуске 45 секунд. На медленном диске containerd в них не уложился: на старте он сверяет состояние оставшихся контейнеров через HCS, а служба vmcompute в эти минуты ещё только запускалась. Действие восстановления «перезапустить службу», которое регистрирует containerd, срабатывает только при падении работающей службы, а не при неудачном старте, и kubelet, зависящий от containerd, тоже остался остановлен. Если такое случается, помогает отложенный автозапуск обеих служб — SCM запускает их примерно через две минуты после загрузки, когда система уже поднялась:
PS C:\> sc.exe config containerd start= delayed-auto
PS C:\> sc.exe config kubelet start= delayed-auto
Отложенным делают и kubelet: служба с обычным автозапуском при старте запускает свои зависимости, и containerd стартовал бы в ту же неудачную минуту. На быстром диске это не нужно.
Дожидаемся возвращения узла, проверяем, что revision в status.nodeInfo.kernelVersion выросла, и возвращаем его. Ловушка: kubectl wait --for=condition=Ready сразу после Restart-Computer завершается мгновенно — узел ещё числится Ready, пока контроллер узлов не заметит, что kubelet перестал продлевать Lease (параметр --node-monitor-grace-period kube-controller-manager, по умолчанию 50 секунд), а быстрый узел успевает перезагрузиться раньше и не бывает NotReady вовсе. Надёжный признак перезагрузки — status.nodeInfo.bootID: kubelet сообщает идентификатор загрузки ОС, на Windows это счётчик загрузок. Запоминаем его до перезагрузки и ждём, пока он сменится:
$ BOOT=$(kubectl get node k8s-lab-win-1 -o jsonpath='{.status.nodeInfo.bootID}'); echo $BOOT
11
$ until [ "$(kubectl get node k8s-lab-win-1 -o jsonpath='{.status.nodeInfo.bootID}')" != "$BOOT" ]; do sleep 5; done
$ kubectl get node k8s-lab-win-1 -o jsonpath='{.status.nodeInfo.bootID}{"\n"}'
12
Вторая ловушка — слишком ранний uncordon. На стенде узел вернулся через 10 секунд, мы сразу сняли cordon, и поды, созданные в первые секунды, пока Calico ещё пересоздавал сеть HNS, остались без связи с узлом: пробы kubelet до них не доходили, hello-win ушёл в CrashLoopBackOff, а aspnetapp так и не стал готовым.
$ kubectl -n win-demo get events --sort-by=.lastTimestamp | grep Unhealthy | tail -1
4m51s       Warning   Unhealthy                pod/aspnetapp-769559d8ff-btj9j        Readiness probe failed: Get "http://172.21.41.34:8080/": context deadline exceeded (Client.Timeout exceeded while awaiting headers)
Те же поды, пересозданные через несколько минут, заработали сразу. Контейнеры calico-node-windows и kube-proxy-windows после загрузки перезапускаются не мгновенно: на стенде — через 28 секунд после Restart-Computer, то есть позже, чем узел вернулся в API. Поэтому перед uncordon дожидаются, что HostProcess-поды Calico и kube-proxy на узле перезапустились после загрузки и готовы — свежий перезапуск в колонке RESTARTS и полный READY. С таким ожиданием все семь Windows-подов стенда после uncordon были готовы через 19 секунд, без единого перезапуска:
$ kubectl get pods -A -o wide --field-selector spec.nodeName=k8s-lab-win-1 | grep -E 'NAME|calico-node|kube-proxy'
NAMESPACE       NAME                        READY   STATUS    RESTARTS      AGE   IP              NODE
calico-system   calico-node-windows-q54h2   2/2     Running   6 (11m ago)   14h   192.168.10.25   k8s-lab-win-1
kube-system     kube-proxy-windows-z9qdq    1/1     Running   3 (11m ago)   14h   192.168.10.25   k8s-lab-win-1
$ kubectl uncordon k8s-lab-win-1
node/k8s-lab-win-1 uncordoned
Ожидавшие поды возвращаются на узел за секунды: образы остались на его диске, скачивать их заново не нужно.
Аварийное выключение и чистка узла
Плановая перезагрузка начинается с drain, авария — нет. Проверим на стенде: выключим виртуальную машину k8s-lab-win-1 без завершения работы, как при скачке напряжения (Stop-VM -TurnOff в Hyper-V), и через 47 секунд включим снова.
Первое, что видно: пока узел выключен, кластер этого не замечает. Узел числится Ready до 50 секунд (--node-monitor-grace-period), а за ним ещё 5 минут поды остаются на месте — у каждого пода толерантность node.kubernetes.io/unreachable на 300 секунд. Все это время эндпоинты hello-win готовы, и трафик идёт на выключенный узел. Наш узел вернулся раньше, чем его признали недоступным:
14:04:16 node=Ready pods=[ 7 1/1/Running,] hello-win-eps=[true true ]
14:04:31 node=Ready pods=[ 7 0/1/Unknown,] hello-win-eps=[]
14:05:01 node=Ready pods=[ 4 0/1/Running, 3 1/1/Running,] hello-win-eps=[false false ]
Дальше хуже. kubelet после загрузки обнаружил, что песочницы подов пропали, и пересоздал их на месте, с новыми адресами — в первые секунды, когда Calico ещё не пересоздал сеть HNS:
$ kubectl -n win-demo get events --sort-by=.lastTimestamp | grep -E 'SandboxChanged|Unhealthy' | tail -3
31s         Normal    SandboxChanged           pod/aspnetapp-769559d8ff-d4p9p        Pod sandbox changed, it will be killed and re-created.
23s         Warning   Unhealthy                pod/aspnetapp-769559d8ff-d4p9p        Readiness probe failed: Get "http://172.21.41.62:8080/": context deadline exceeded (Client.Timeout exceeded while awaiting headers)
15s         Warning   Unhealthy                pod/hello-win-759c899954-dkqlw        Startup probe failed: Get "http://172.21.41.4:8080/healthz": context deadline exceeded (Client.Timeout exceeded while awaiting headers)
Поды выглядели Running, но без сети: в HNS-сети Calico у них не оказалось конечных точек, до них не доходили ни пробы kubelet, ни Linux-поды, а reports не видел SQL Server. Само это не проходит: Calico был готов через минуту после включения, а через пять минут hello-win всё ещё перезапускался по кругу. Лечится пересозданием подов — новые получают сеть сразу:
$ kubectl -n win-demo delete pod --all
Но старые поды застревают в Terminating: kubelet не может удалить их песочницы, потому что их пространства имён HNS ссылаются на сеть, которой больше нет:
$ kubectl -n win-demo describe pod aspnetapp-769559d8ff-d4p9p | grep FailedKillPod
  Warning  FailedKillPod     3m42s (x4 over 4m8s)   kubelet            error killing pod: failed to "KillPodSandbox" for "8e3b0fe0-fc30-4d70-b93d-10d10e3edfa8" with KillPodSandboxError: "rpc error: code = Unknown desc = failed to remove network namespace for sandbox …: hcnDeleteNamespace failed in Win32: The specified request is unsupported. …"
kubectl delete pod --force --grace-period=0 убирает объекты из API, но не с узла: песочницы остаются в containerd в состоянии NotReady, а crictl rmp -f и hnsdiag delete namespaces упираются в ту же ошибку The specified request is unsupported.
PS C:\> crictl pods --namespace win-demo --state NotReady
POD ID              CREATED             STATE               NAME                             NAMESPACE           ATTEMPT             RUNTIME
45a3409f3b865       9 minutes ago       NotReady            hello-win-759c899954-dkqlw       win-demo            1                   runhcs-wcow-process
799004ca4b9f7       9 minutes ago       NotReady            aspnetapp-769559d8ff-d4p9p       win-demo            1                   runhcs-wcow-process
...
Чистку делает обычная процедура обслуживания — та же, что для обновлений, только уже после аварии: drain, перезагрузка, ожидание смены bootID и перезапуска Calico и kube-proxy, uncordon. Пространства имён HNS не переживают перезагрузку, и containerd при старте спокойно удаляет осиротевшие песочницы:
PS C:\> crictl pods --namespace win-demo
POD ID              CREATED             STATE               NAME                NAMESPACE           ATTEMPT             RUNTIME
PS C:\> (hnsdiag list namespaces | Select-String '^Namespace').Count
1
На стенде после такой перезагрузки все семь Windows-подов были готовы через 20 секунд после uncordon. Отсюда правило: Windows-узел после аварийного выключения не считают здоровым, даже если он Ready. Его сразу осушают и перезагружают штатно — это быстрее, чем разбираться с подами без сети по одному, и не оставляет мусора в containerd и HNS.
kubelet, kubeadm и containerd на Windows-узле обновляются в том же порядке, что на Linux, — после control plane, на осушённом узле: остановить службу kubelet, заменить kubeadm.exe и kubelet.exe файлами новой версии, выполнить kubeadm upgrade node --patches C:\k\patches (патчи kubeadm не хранит, как разобрано в части 38), запустить службу. Политика перекоса версий для Windows-узла та же.
Новая версия Windows Server
Раз в несколько лет выходит новая LTSC-версия Windows Server с новой сборкой. Обновлять ОС узла на месте не стоит: надёжнее ввести новый узел и вывести старый, как в части 35. Порядок для гибридного кластера определяется правилом совместимости: новый узел запускает образы предыдущей LTSC-версии, старый узел новые образы не запускает.
- Ввести узлы новой версии. kubelet сам ставит им метку
node.kubernetes.io/windows-buildс новой сборкой. Для них создаётся новый RuntimeClass —windows-20NNсо своимnodeSelector— тот же taint и тот же handler. - Пересобрать образы с двумя Windows-вариантами. Индекс содержит
windows/amd64сos.version26100 иwindows/amd64с новой сборкой; каждый узел возьмёт свой. Сборка — двумя прогонами с разными базовыми образами иimagetools create, как выше. - Переключить Deployment на новый RuntimeClass обычным обновлением: поды пересоздадутся на новых узлах.
- Осушить и вывести старые узлы, затем убрать из сборки вариант
ltsc2025и старый RuntimeClass.
Шаг 2 можно отложить: благодаря совместимости вниз новые узлы запустят и образы ltsc2025. Но документация Kubernetes по-прежнему говорит о строгой совместимости версий узла и образа, а код выбора платформы в containerd знает только те LTSC-версии, что существовали на момент его выпуска. Поэтому переход на новую базу — обязательная часть миграции, а совместимость вниз — запас на её время.
Смотрим руками
Всё ниже — в тестовом кластере (текущий контекст lab). Поды и узлы:
$ kubectl get nodes -L kubernetes.io/os,node.kubernetes.io/windows-build
NAME               STATUS   ROLES           AGE    VERSION   OS        WINDOWS-BUILD
k8s-lab-master-1   Ready    control-plane   15h    v1.37.2   linux
k8s-lab-node-1     Ready    <none>          14h    v1.37.2   linux
k8s-lab-node-2     Ready    <none>          14h    v1.37.2   linux
k8s-lab-win-1      Ready    <none>          13h    v1.37.2   windows   10.0.26100
$ kubectl -n win-demo get pods -l app.kubernetes.io/name=hello-win -o wide
NAME                         READY   STATUS    RESTARTS   AGE   IP             NODE
hello-win-759c899954-tkfg6   1/1     Running   0          42m   172.21.41.16   k8s-lab-win-1
hello-win-759c899954-tq5nc   1/1     Running   0          42m   172.21.41.18   k8s-lab-win-1
Какой вариант образа взял containerd:
PS C:\> crictl images | Select-String 'hello'
ghcr.io/example/hello                         1.3                             7ffd115839b16       201MB
PS C:\> crictl inspecti ghcr.io/example/hello:1.3 | ConvertFrom-Json |
          Select-Object -ExpandProperty info | Select-Object -ExpandProperty imageSpec |
          Select-Object os, 'os.version', architecture

os      os.version       architecture
--      ----------       ------------
windows 10.0.26100.33674 amd64
В статусе пода imageID — дайджест индекса sha256:912dccf9…, общий для всех платформ, а на узле лежит только Windows-вариант со своей базой: 201 МБ против семи мегабайт Linux-варианта.
Во что превратились limits — в спецификации контейнера, которую containerd передал runhcs:
PS C:\> $id = crictl ps --name hello -q | Select-Object -First 1
PS C:\> (crictl inspect $id | ConvertFrom-Json).info.runtimeSpec.windows.resources | ConvertTo-Json
{
    "cpu": {
        "maximum": 1250
    },
    "memory": {
        "limit": 268435456
    }
}
maximum: 1250 — 12,5 % от четырёх процессоров узла, то есть пол-ядра; limit — 256 МиБ. Следов requests здесь нет. Фактическое потребление:
$ kubectl -n win-demo top pods -l app.kubernetes.io/name=hello-win
NAME                         CPU(cores)   MEMORY(bytes)
hello-win-759c899954-tkfg6   0m           41Mi
hello-win-759c899954-tq5nc   0m           41Mi
$ kubectl -n demo top pods
NAME                     CPU(cores)   MEMORY(bytes)
hello-55fb8f8684-69mvv   1m           3Mi
hello-55fb8f8684-nztv2   1m           4Mi
Около 41 МиБ рабочей памяти — вместе с системными процессами контейнера; тот же hello на Linux занимает 3–4 МиБ.
SMB-том на узле — глобальное сопоставление и ссылка staging:
PS C:\> Get-SmbGlobalMapping | Format-List Status, RemotePath, RequirePrivacy

Status         : OK
RemotePath     : \\files.example.com\k8s\win-demo-reports-pvc-ea3d8e0f-a51d-4662-9e44-b9174787e9a2
RequirePrivacy : True

PS C:\> Get-Item C:\var\lib\kubelet\plugins\kubernetes.io\csi\smb.csi.k8s.io\*\globalmount |
          Select-Object LinkType, Target

LinkType     Target
--------     ------
SymbolicLink {UNC\files.example.com\k8s\win-demo-reports-pvc-ea3d8e0f-a51d-4662-9e44-b9174787e9a2}

PS C:\> Get-SmbConnection -ServerName files.example.com | Format-List Dialect, Encrypted, Signed

Dialect   : 3.1.1
Encrypted : True
Signed    : False
Диалект 3.1.1, шифрование включено, а отдельная подпись не нужна: зашифрованные сообщения и так защищены от подмены (Signed : False — не дыра). Поле UserName у Get-SmbConnection здесь не поможет: в нём учётная запись, от которой соединение открыто на узле, — сам компьютер, — а не учётная запись из Secret. Кто вошёл на шару, видно на сервере:
user@files:~$ sudo smbstatus -b | tail -1
47241   svc-k8s-smb  svc-k8s-smb  192.168.10.25 (ipv4:192.168.10.25:51032)  SMB3_11           AES-128-GCM          AES-128-GMAC
Сессия от svc-k8s-smb с Windows-узла, SMB 3.1.1 с шифрованием AES-128-GCM — то же, что smbstatus показывал для Linux-узлов в части 24. А в каталоге тома на сервере — файл, который пишет reports-writer.
Логи в Loki тестового кластера. logcli настроен так же, как в части 33: port-forward к loki-gateway и LOKI_ADDR:
$ kubectl --context lab -n monitoring port-forward svc/loki-gateway 3100:80 &
$ export LOKI_ADDR=http://localhost:3100
$ logcli query --since=10m --limit=1 '{namespace="win-demo", container="hello", node="k8s-lab-win-1"} |= "request served"'
Common labels: {app="hello-win", container="hello", detected_level="info", filename="C:\\var\\log\\pods\\win-demo_hello-win-759c899954-tq5nc_3b4bacb8-8648-4657-b537-50eb6d76f8e6\\hello\\0.log", namespace="win-demo", node="k8s-lab-win-1", pod="hello-win-759c899954-tq5nc", service_name="hello-win", stream="stdout"}
2026-11-07T12:51:08+03:00 {} {"time":"2026-11-07T12:51:08.5249253+03:00","level":"INFO","msg":"request served","method":"GET","path":"/","status":200,"duration_ms":0,"trace_id":"eb1358f432ff7e6221bed5aad2d9a8f9","span_id":"277be3ba4e239b4b","trace_sampled":false}
Журнал событий узла. Чтобы в канале System появилась ошибка, аварийно завершим процесс containerd — контейнеры при этом продолжают работать, их shim от containerd не зависят:
PS C:\> Stop-Process -Name containerd -Force
$ logcli query --since=1h --limit=1 -o raw '{job="windows-events"} | json | event_id="7031" | line_format "{{.source}} {{.event_id}} {{.levelText}}: {{.message}}"'
Service Control Manager 7031 Error: The containerd service terminated unexpectedly.  It has done this 1 time(s).  The following corrective action will be taken in 15000 milliseconds: Restart the service.
Событие 7031 диспетчера служб пришло в Loki через три секунды. Через 15 секунд SCM сам перезапустил containerd — это действие восстановления, которое containerd регистрирует для своей службы, — а kubelet переподключился к нему без перезапуска. Запись целиком — JSON с источником, каналом, кодом события, уровнем, временем, номером записи и процессом, который её написал (services.exe); фильтр | json разбирает эти поля в метки, по ним и строится выборка.
На Windows-узле теперь работает собственное приложение из того же тега, что и на Linux, с понятными лимитами, корректной остановкой, SMB-томом, логами в Loki и метриками в Prometheus, а обновление узла стало ежемесячной процедурой. Но hello-win пока ходит к внешним ресурсам только как анонимный процесс: учётные записи внутри контейнера существуют лишь в нём самом, и войти от их имени в домен Active Directory нельзя.
Источники
- Kubernetes: Windows containers in Kubernetes, Resource Management for Windows nodes, HostProcess pods, Resize CPU and Memory Resources, Node Shutdowns.
- Microsoft: Windows container version compatibility, Update Windows Server containers, Persistent storage in containers, LogMonitor, hcsshim PR #1416.
- BuildKit и containerd: BuildKit на Windows, PR #3619 и PR #5714 об
os.version, сопоставление платформ Windows в containerd. - Хранилище: csi-proxy, параметры чарта csi-driver-smb.
- Наблюдаемость: windows_exporter, чарт prometheus-windows-exporter, loki.source.windowsevent, Go os/signal.
Дальше — часть 40, gMSA: вход в Active Directory из Windows-подов. Что такое групповая управляемая учётная запись службы и зачем поду доменная учётная запись; credential spec и CRD GMSACredentialSpec, вебхук gMSA и RBAC на использование спецификации; узлы в домене против плагина CCG (Container Credential Guard) для узлов вне домена; проверка через nltest и билеты Kerberos и типичные ошибки.
Оставить комментарий могут только зарегистрированные пользователи.
Войдите на сайт или зарегистрируйтесь, чтобы оставить комментарий.